


コーディングエージェントの評価指標v2.1、Claude Fable 5.2とOpus 5.5が58で首位
原題: Announcing Artificial Analysis Coding Agent Index v2.1, upgrading FrontierCode and Termin…
投稿の要約
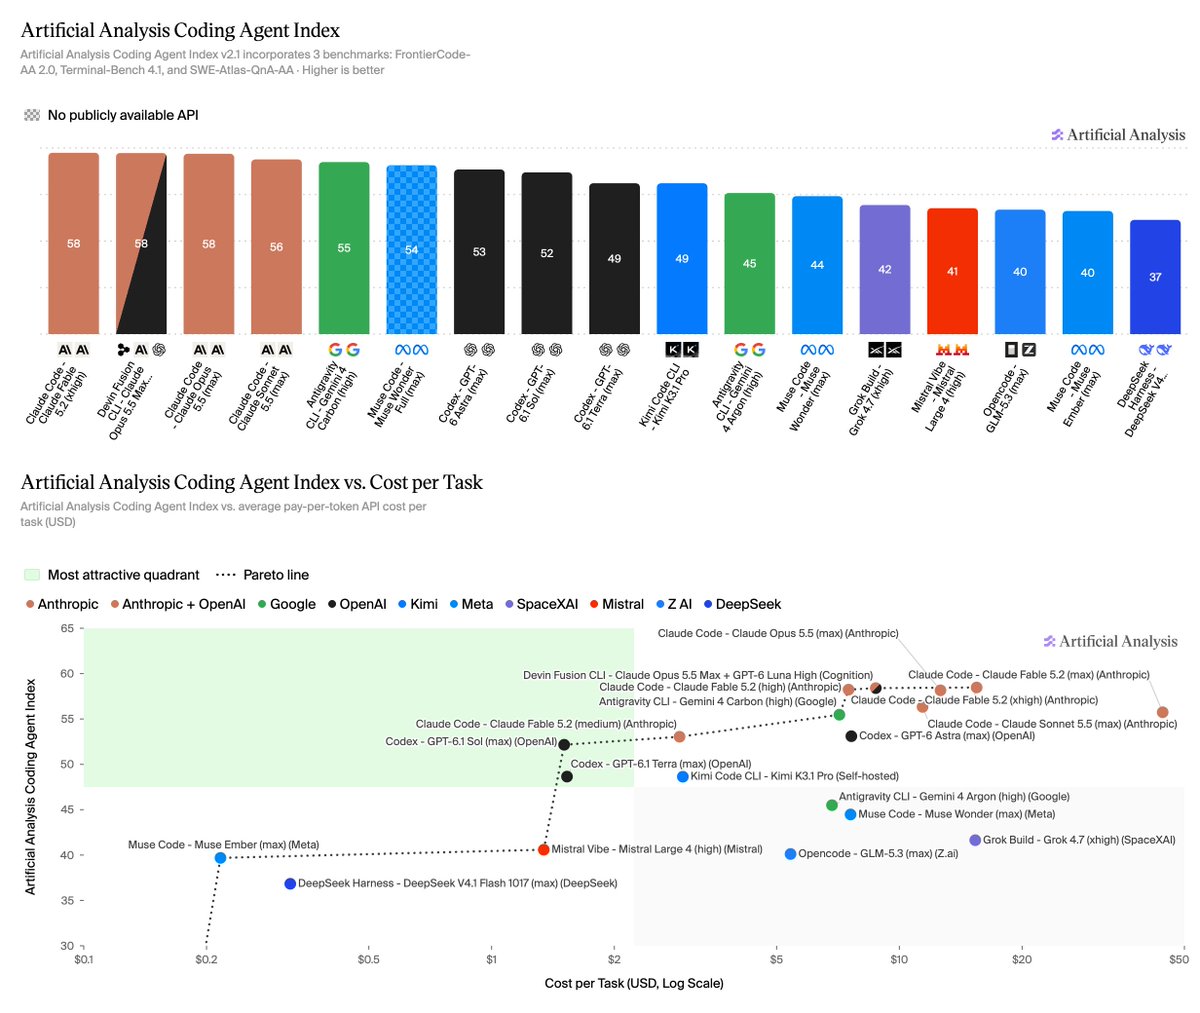
AIの評価機関Artificial Analysisが、エージェントとして動かしたときのコーディング力を測る「Coding Agent Index」をv2.1に更新し、結果を公表しました。
- テストのうちFrontierCodeを2.0(実際のリポジトリの132課題を、メンテナーがマージするかで採点)に、Terminal-Benchを4.1(同じ66課題で、採点の仕組みを改善)に更新しました
- 首位はClaude Code上のClaude Fable 5.2と、Claude Opus 5.5で、ともに58でした
- 次いでClaude Sonnet 5.5が56、Antigravity CLI上のGemini 4 Carbonが55です
- 更新でスコアは平均5ポイント下がり、前の版から下がらなかったのはCodexとGPT-6.1 Terraの組み合わせだけでした
- 48以上の組み合わせでも1課題あたりの費用は約30倍の差があり、CodexとGPT-6.1 Solの1.51ドルから、Claude CodeとClaude Fable 5.2(max)の44.22ドルまで開きがあります
出典
- 引用元
- X
- 投稿者
- @ArtificialAnlys
- 種類
- X
- サイト
- x.com
- 元の投稿の
日時 - 2026年11月14日(土) 09:04(日本時間)
- 反響
- いいね 934・ブックマーク 178・表示 200,407(取得時点)