


画像を理解するAIの「視覚エンコーダー」は必要か 200以上のモデルで比べた研究
原題: Labs disagree on vision encoders for MLLMs! ⚔️
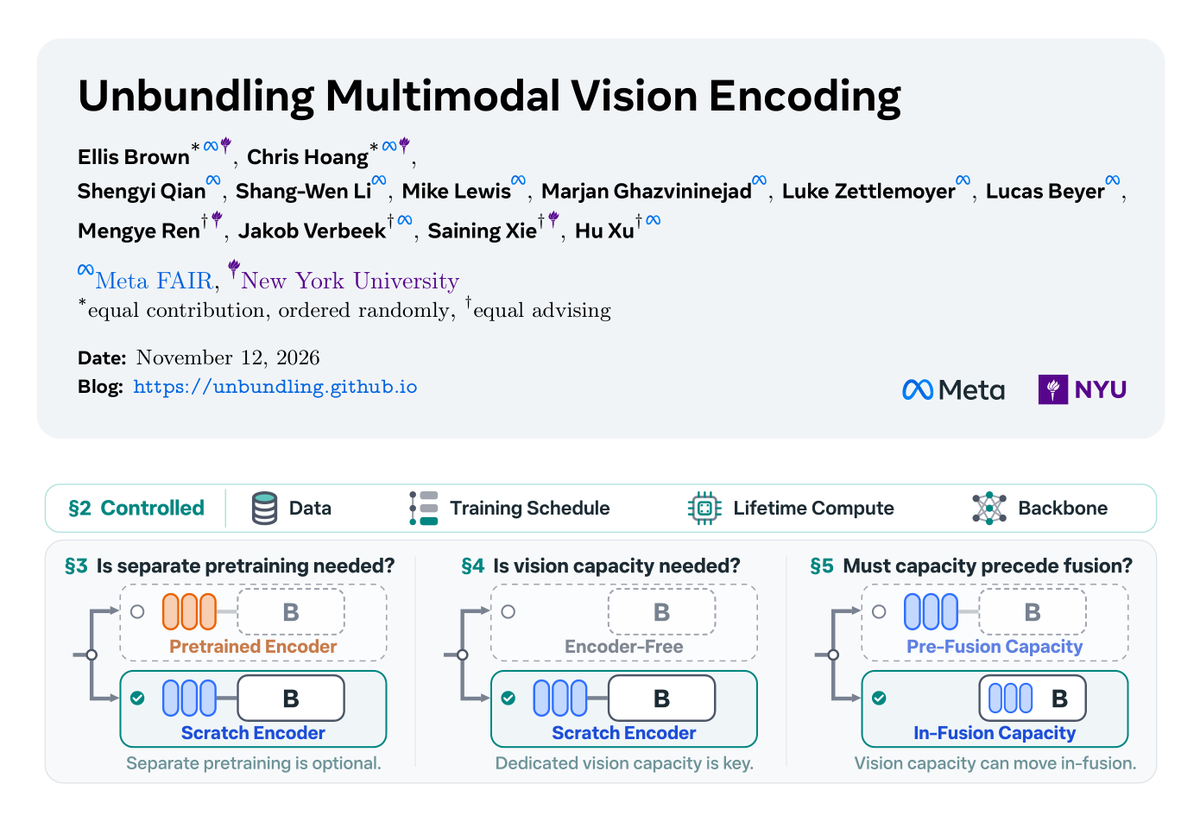
投稿の要約
マルチモーダルモデル(文章と画像を扱うAI)で、画像をどう取り込むのが良いかを調べた研究の紹介投稿が反響を集めています。
- 最近はGemma 4 12Bが視覚エンコーダー(画像を数値に変える専用の部品)をなくし、Kimi K3がその事前学習をやめるなど、各社の判断が分かれているとしています
- 研究チームは条件をそろえて200以上のモデルをゼロから学習させて比べました
- 結論は「画像用のパラメーターは残し、その事前学習は省いてよい。しかもエンコーダーの形である必要はない」というものです
画像を扱うAIの設計で、どこに手間をかけるべきかを示した結果です。
出典
- 引用元
- X
- 投稿者
- @choang333
- 種類
- X
- サイト
- x.com
- 元の投稿の
日時 - 2026年11月14日(土) 05:12(日本時間)
- 反響
- いいね 662・ブックマーク 587・表示 70,679(取得時点)